batch_size 的复杂性来自 TP、DP、SP 三个维度的交织。本文先讲清楚「一个
batch 是怎么从 global 流到一张 GPU 的」,再讲两条 micro-batch
切分路径(静态/动态),最后展开动态路径背后的
use_dynamic_bsz、_balance_batch、all_reduce(MAX)
同步等关键机制。
引用浅入理解verl中的batch_size的解释:
vllm + fsdp 训推时, 如果每张卡都是一个 DP, 事情会简单很多。但 verl 中有两个功能不满足这一条件, 一是 rollout 时让 vllm 开启 TP, 二是在 fsdp 中使用 ulysses (SP)。verl 中数据分发使用的是 dispatch mode 这一机制, 比如 fsdp workers 主要使用
Dispatch.DP_COMPUTE_PROTO这个 mode, 它是在 worker group 的层次上进行数据分发以及结果收集的。由于这个层次是没有 TP/SP 概念的, 所以它仅在 one GPU one DP 时才是正确的。那么为了正确支持 TP/SP, 就需要对数据做一些前后处理。
这一点在 DataProto 也有提到,
具体的实现就是 all_gather_data_proto 函数。
- TP 需要在 TP rank 上 all-gather 来保证各个 tp rank 的输入相同, 然后再将输出 split 返回当前 rank 的部分, 保持和输入一致。
- SP 与 TP 一样, 在 SP group 上进行 allgather 来保证各个 SP rank 的输入相同 (ulysses 的需要); 对输出进行 split 并返回当前 rank 对应的部分。
fsdp_worker 初始化时的 batch_size 处理
# normalize config
if self._is_actor:
    self.config.actor.ppo_mini_batch_size *= self.config.rollout.n
    self.config.actor.ppo_mini_batch_size //= self.device_mesh.size() // self.ulysses_sequence_parallel_size
    assert self.config.actor.ppo_mini_batch_size > 0, (
        f"ppo_mini_batch_size {self.config.actor.ppo_mini_batch_size} should be larger than 0 after "
        f"normalization"
    )
    # micro bsz
    if self.config.actor.ppo_micro_batch_size is not None:
        self.config.actor.ppo_micro_batch_size //= (
            self.device_mesh.size() // self.ulysses_sequence_parallel_size
        )
        self.config.actor.ppo_micro_batch_size_per_gpu = self.config.actor.ppo_micro_batch_size

    if self.config.actor.ppo_micro_batch_size_per_gpu is not None:
        assert self.config.actor.ppo_mini_batch_size % self.config.actor.ppo_micro_batch_size_per_gpu == 0, (
            f"normalized ppo_mini_batch_size {self.config.actor.ppo_mini_batch_size} should be divisible by "
            f"ppo_micro_batch_size_per_gpu {self.config.actor.ppo_micro_batch_size_per_gpu}"
        )
        assert self.config.actor.ppo_mini_batch_size // self.config.actor.ppo_micro_batch_size_per_gpu > 0, (
            f"normalized ppo_mini_batch_size {self.config.actor.ppo_mini_batch_size} should be larger than "
            f"ppo_micro_batch_size_per_gpu {self.config.actor.ppo_micro_batch_size_per_gpu}"
        )
# normalize rollout config
if self._is_rollout and self.config.rollout.log_prob_micro_batch_size is not None:
    self.config.rollout.log_prob_micro_batch_size //= (
        self.device_mesh.size() // self.ulysses_sequence_parallel_size
    )
    self.config.rollout.log_prob_micro_batch_size_per_gpu = self.config.rollout.log_prob_micro_batch_size
# normalize ref config
if self._is_ref and self.config.ref.log_prob_micro_batch_size is not None:
    self.config.ref.log_prob_micro_batch_size //= self.device_mesh.size() // self.ulysses_sequence_parallel_size
    self.config.ref.log_prob_micro_batch_size_per_gpu = self.config.ref.log_prob_micro_batch_size
前面创建了 fsdp_devicmesh(dp)、ulysses_device_mesh(dp 和 sp) 以及在初始化 rollout 中创建了 rollout_device_mesh(dp 和 tp)。具体可以查看 device_mesh。
Rollout
注意 verl v0.5.0 的实现中, 所有的 prompts 直接由 driver 重复然后再 dispatch, 而不是先 dispatch 然后再交给 Worker 重复样本。这样做的目的是如果先分片的话, 有可能 batch_size 小于 world_size (对我来说基本不可能), 导致不能正确切分, 如果是先 repeat 的话就可以了。
因此对于 Rollout: -
全局:train_batch_size * n 个 prompts, 输出
train_batch_size * n 个 prompts + responses。 -
单卡: 输入
train_batch_size * n / world_size 个 prompts, 进行前处理为
\(\frac{train\_batch\_size \cdot
n}{world\_size} \cdot tp\_size\) 个 prompts, 然后进行推理, 得到
\(\frac{train\_batch\_size \cdot
n}{world\_size} \cdot tp\_size\) 个 prompts+responses,
再进行后处理, 输出 train_batch_size * n / world_size 个
prompts+responses。
Actor
与 Actor 有关的参数为 ppo_mini_batch_size(决定一批
experience
的更新次数)、rollout.log_prob_micro_batch_size_per_gpu(计算
old_logp)、ref.log_prob_micro_batch_size_per_gpu(计算
ref_logp)、micro_batch_size_per_gpu(直接指定单卡上的
batch_size)。
重点看 ppo_mini_batch_size 用于 update_policy 的处理, 其它的都大同小异:
- 全局:
train_batch_size * n大小的 batch, 包含了部分计算好的 experience。 - 单卡: 输入为
train_batch_size * n / world_size, 经过前处理为train_batch_size * rollout_n * sp_size / world_size。这和 fsdp_worker 初始化时的 ppo_mini_batch_size 一致, 即
self.config.actor.ppo_mini_batch_size *= self.config.rollout.n
self.config.actor.ppo_mini_batch_size //= self.device_mesh.size() // self.ulysses_sequence_parallel_size
这样的话对于一批 experience 的更新次数, 就等于你传入的
train_batch_size // mini_batch_size。对于
micro_batch_size_per_gpu 参数来说, 可以直接指定单卡的
bsz。对于传入 micro_batch_size 再计算的方式, verl
已经废弃了。
ppo 流程
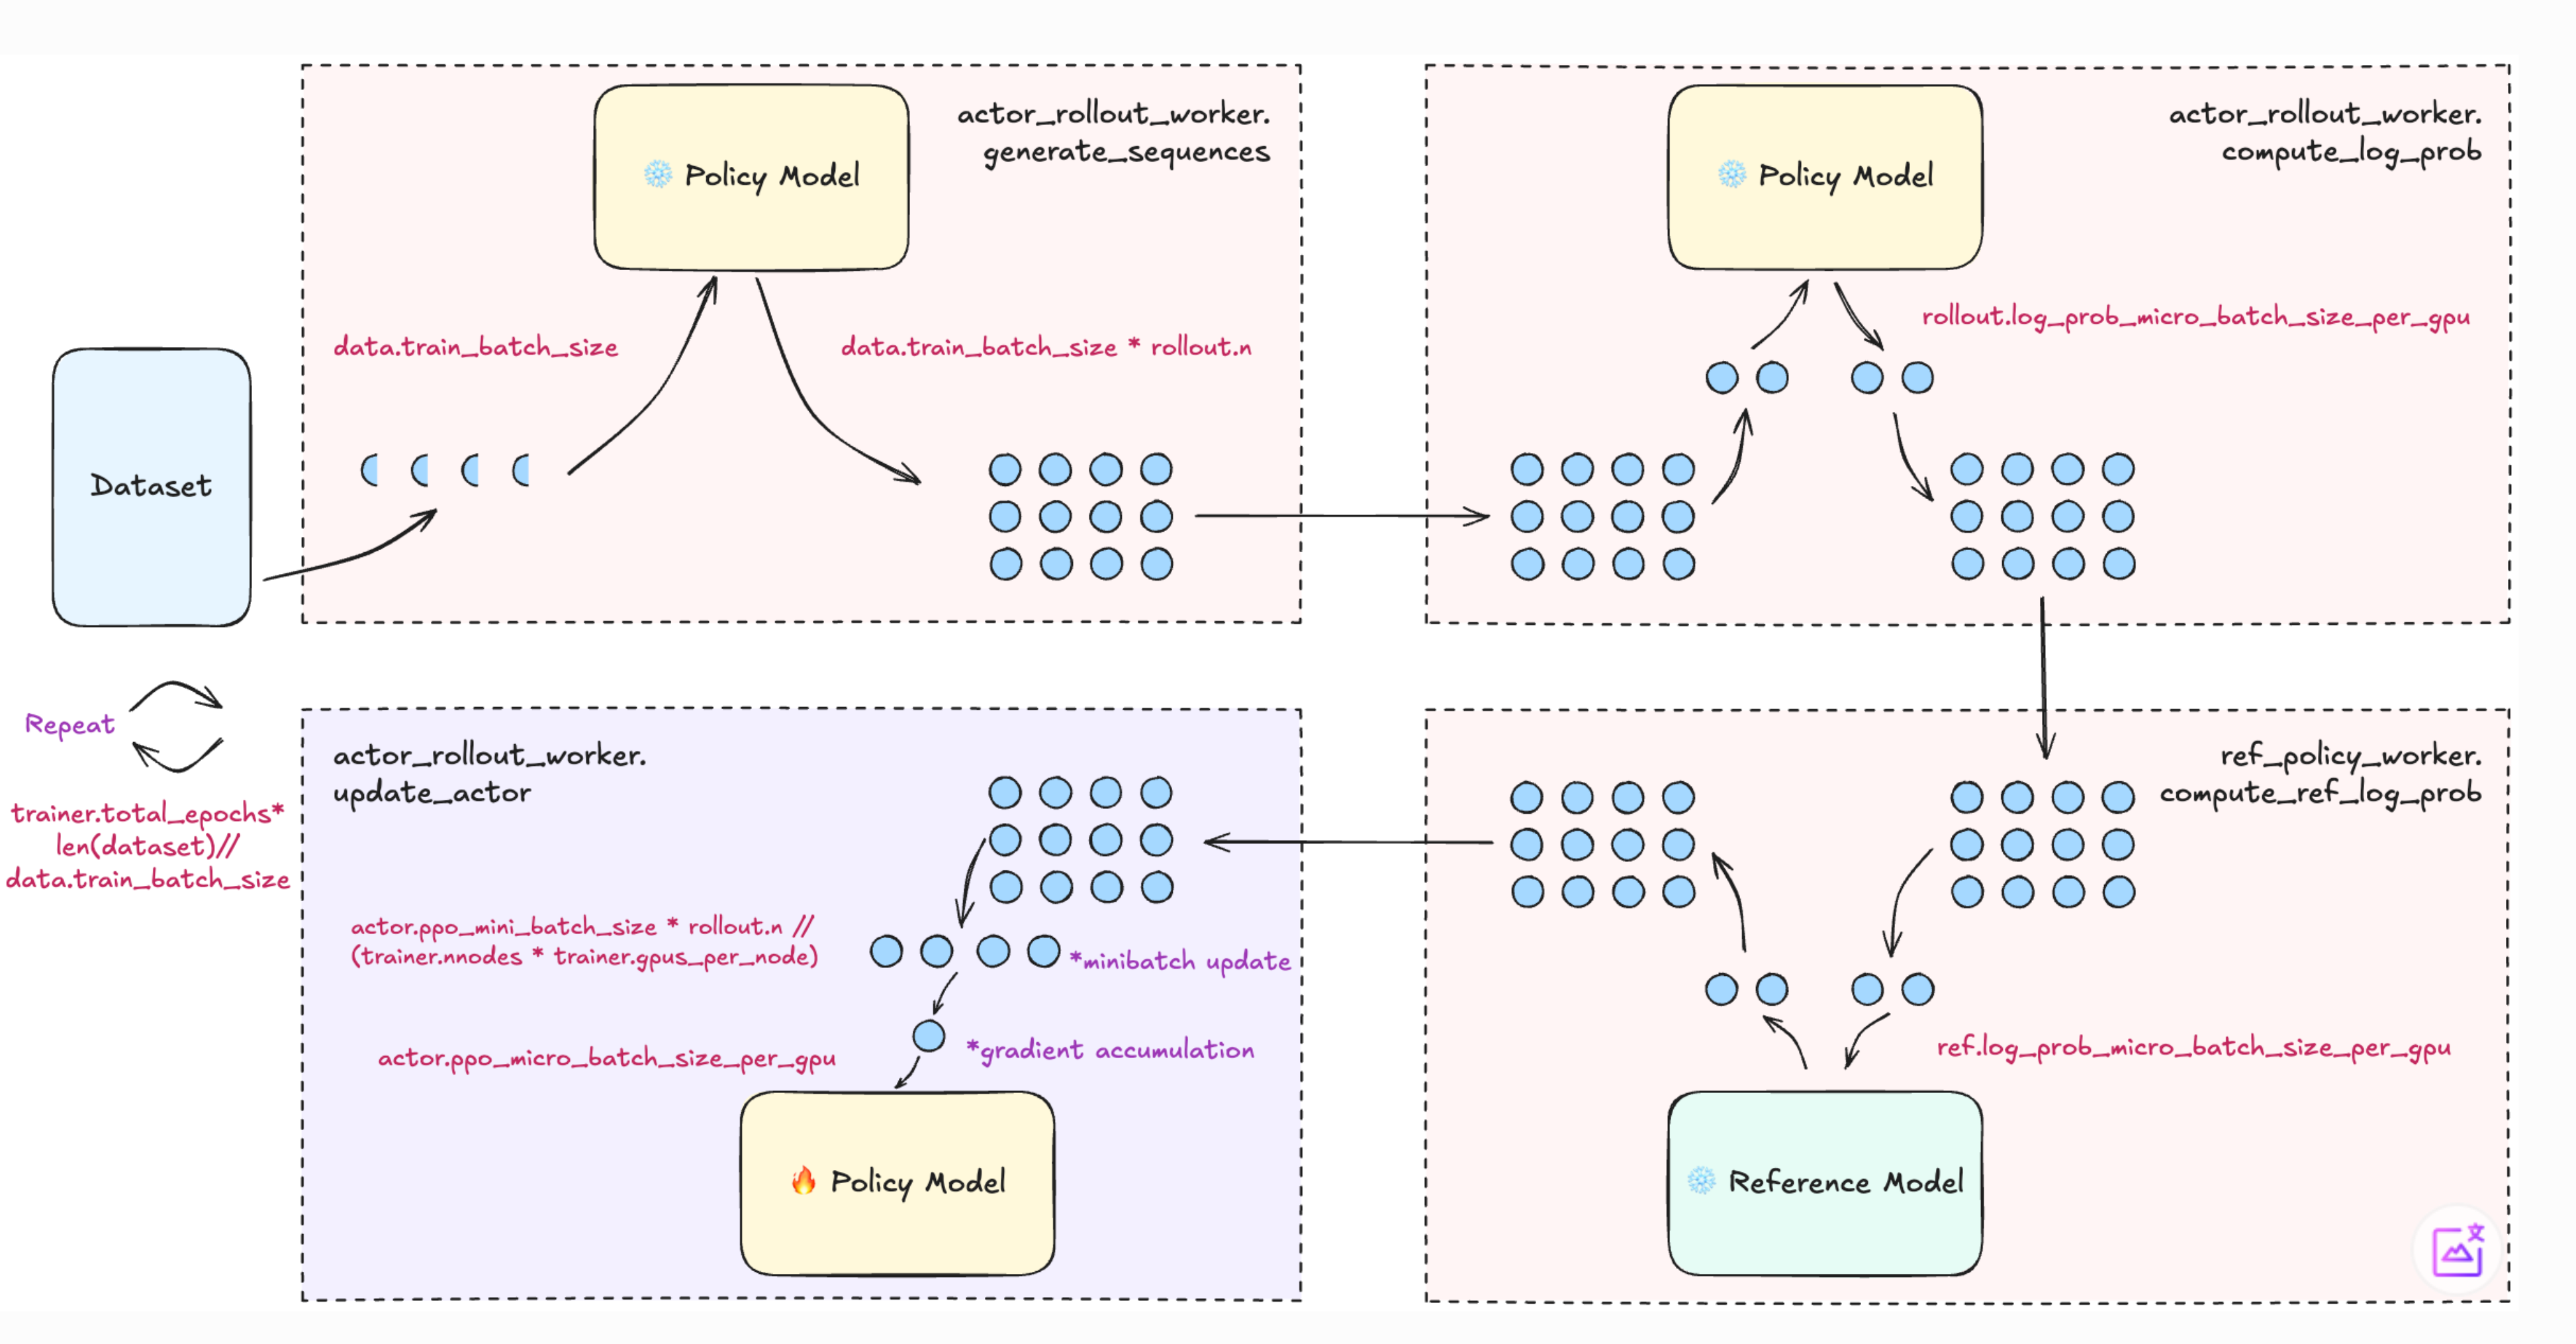
从图中可以得到的是 ppo_mini_batch_size 是全局的
prompt batch, 而 ppo_micro_batch_per_gpu
是每一个 GPU 上的 prompt+response batch,
所以由此可以得到梯度累计的 steps 为
ppo_mini_batch_size * n * sp_size // world_size // micro_batch_per_gpu。即
micro_batch_per_gpu 代表梯度累计的 bsz。
两条 micro-batch 切分路径
上面四节都把 batch 视为按”条数”切分, 但实际 verl
训练侧有两条切分路径, 由 use_dynamic_bsz
二选一:
| 路径 | 触发参数 | 切分依据 | 平衡目标 |
|---|---|---|---|
| 路径 A: 静态切分 | use_dynamic_bsz=False (默认) |
micro_batch_size_per_gpu 条样本 |
不做平衡 |
| 路径 B: 动态切分 | use_dynamic_bsz=True |
max_token_len_per_gpu 个 token |
KK 算法平衡 token 总数 |
三层 batch 概念
先看清”batch size”这个词在不同位置的含义, 数据从一步训练流到一张 GPU 经过三层:

verl 在数据流上做了两层 KK 平衡: - 第 1 层
(默认开, trainer.balance_batch=True): single
controller 跨 DP rank 全局重排, 在 _balance_batch 中做一次
KK。 - 第 2 层 (要开 use_dynamic_bsz):
每个 rank 内切 micro-batch 时再做一次 KK, 按 token 预算打包。
路径 A: 静态切分 (默认)
关键参数: ppo_micro_batch_size_per_gpu /
log_prob_micro_batch_size_per_gpu。逻辑非常简单,
按样本条数等分。
# verl/workers/engine/utils.py
if use_dynamic_bsz:
    ...
else:
    total_data_size = len(data)
    micro_batch_size_per_gpu = data["micro_batch_size_per_gpu"]
    assert total_data_size % (force_group_size * micro_batch_size_per_gpu) == 0
    micro_batches = tu.chunk_tensordict(
        data, total_data_size // (micro_batch_size_per_gpu * force_group_size)
    )
特性: - 条数固定: 每个 micro-batch 恰好
micro_batch_size_per_gpu 条样本, 无论它们多长。 -
显存不可控: 极端情况一个 micro-batch 全是长样本, token
总数远超预期, OOM。 - DP 间天然对齐: 每张卡的
micro-batch 数完全一致, FSDP/Megatron 的集合通信节奏天然同步。 -
失衡浪费算力: 短样本 padding 到 batch 里最长那条,
长样本拉低吞吐, GPU 利用率低。
路径 B: 动态切分
(use_dynamic_bsz=True)
关键参数: ppo_max_token_len_per_gpu。不再按条数切,
而是给每张卡一个 token 预算, 由算法去打包。
入口代码:
# verl/workers/engine/utils.py — prepare_micro_batches()
if use_dynamic_bsz:
    assert "max_token_len_per_gpu" in data.keys()
    max_token_len_per_gpu = data["max_token_len_per_gpu"]
    max_token_len = max_token_len_per_gpu * sp_size   # SP 倍率
    micro_batches, batch_idx_list = rearrange_micro_batches(
        data, max_token_len=max_token_len,
        dp_group=dp_group,
        same_micro_num_in_dp=same_micro_num_in_dp,   # 关键
        ...
)三步切分流程:
步骤 1: 算每张卡至少要切几个 micro-batch。
total_seqlen     = attention_mask.sum()
num_micro_batches = ceil(total_seqlen / max_token_len)
步骤 2 (dynamic 模式独有): DP 维度同步 micro-batch 数。
if dist.is_initialized() and same_micro_num_in_dp and dp_group is not None:
    num_micro_batches = torch.tensor([num_micro_batches], device=...)
    dist.all_reduce(num_micro_batches, op=dist.ReduceOp.MAX, group=dp_group)
    num_micro_batches = num_micro_batches.cpu().item()
步骤 3: 用 Karmarkar-Karp 算法把样本按工作量平均分进 num_micro_batches 个桶。
# 工作量估算: 模拟 attention FLOPs ≈ 12·h²·L + 2·h·L²
workload = 24576 * seqlen + seqlen ** 2
partitions = karmarkar_karp(workload, k_partitions=num_micro_batches, equal_size=False)
为什么
all_reduce(MAX)不可省: DP 各 rank 拿到的样本长度分布不同 → 各自算出的num_micro_batches不一样 → FSDP forward 循环里调用all_gather的次数不一样 → 集合通信永远配不上对, 直接 NCCL hang。verl 用 MAX 把所有 rank 拉齐到全局最大值, 短的 rank 通过把样本切成更稀疏的桶来对齐 (不是补空 padding)。
_balance_batch:
进 dynamic_bsz 之前的全局 KK 重排
第 03 节的 dynamic_bsz 只管 rank 内的 micro-batch 切分。那 rank
之间的总 token 数谁负责? 答案是: 在 dynamic_bsz 进各 rank 之前, verl 在
single controller 上先做了一次全局 KK 重排, 叫
_balance_batch。由 trainer.balance_batch=True
默认开启。
# verl/trainer/ppo/ray_trainer.py — _balance_batch()
global_seqlen_lst = batch.batch["attention_mask"].sum(-1)
workload_lst = calculate_workload(global_seqlen_lst)
dp_size = self._get_dp_size(self.actor_rollout_wg, "actor")

# equal_size=True: 每个 rank 拿到等条数样本
global_partition_lst = get_seqlen_balanced_partitions(
    workload_lst, k_partitions=dp_size, equal_size=True
)

# 把 batch 按 KK 给的分组重排, 再 chunk 出去
global_idx = torch.tensor([j for partition in global_partition_lst for j in partition])
batch.reorder(global_idx)
这层和 dynamic_bsz 的关键区别:
equal_size=True: 每个 rank 必须拿到等条数样本 (PPO 后续 mini-batch 数对齐需要), KK 在这个硬约束下做平衡。- 只重排顺序, 不重切样本: 原样本不变, 只是 chunk 时被分到不同 rank。
- 对 workload 而非 token 数平衡: 用
12·h²·L + 2·h·L²估算 attention FLOPs, 让长样本被特别”重视”。 - 每个 mini-batch 跑一次, rollout 完成后、进 forward 前。
演示: 16 条样本下发到 4 个 DP rank
同一组 16 条不同长度样本, 按原顺序 chunk vs 经过
_balance_batch 重排后再 chunk。

可以看到 KK 重排后, 各 rank 的总 token 数从原来最大 21,500 / 最小 11,800 (极差 1.82×) 压到了 17,300 / 15,800 (极差 1.09×)。
限制: equal_size=True 让 KK
不能完全自由, 比如”单条特别长的样本”总会落到某个 rank 上、把那个 rank 的
token 总数推高。这是为什么 log 里
balanced_max - balanced_min 不会真的变成 0, 只是从原始的
~10% 极差压到 ~3-5%。
log 里 global_seqlen/min,max
是未重排时的统计;
global_seqlen/balanced_min,balanced_max 是KK
重排后的统计。在自己的训练 metric 里直接对比这两组数字就能看
_balance_batch 在你的数据上有多大效果。
use_dynamic_bsz 数据流
参数定义与作用
| 参数 | 作用 |
|---|---|
ulysses_sequence_parallel_size |
Ulysses 序列并行大小, 将序列切分到多个 GPU 上并行计算 |
use_dynamic_bsz |
动态批处理, 根据 token 总数动态划分 micro batch, 平衡各 batch 的计算量 |
use_remove_padding |
移除 padding, 将多个序列的有效 token 拼接成一个连续序列, 配合 flash_attn_varlen 使用 |
ppo_mini_batch_size |
PPO 训练时每个 mini batch 的样本数 |
ppo_micro_batch_size_per_gpu |
每个 GPU 上的 micro batch 大小 (梯度累积的基本单位) |
compute_log_prob 阶段 (推理 / 计算 log prob)
输入数据 (DataProto)
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 1: 划分 Micro Batches                               │
│  ├─ if use_dynamic_bsz:                                  │
│  │    使用 rearrange_micro_batches() 按 token 总数动态划分  │
│  │    max_token_len = meta_info["max_token_len"] * sp_size│
│  │    返回重排后的 micro_batches 和 indices                │
│  └─ else:                                                │
│       按固定 micro_batch_size 均匀切分                     │
└──────────────────────────────────────────────────────────┘
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 2: 对每个 Micro Batch 进行前向计算                   │
│  └─ _forward_micro_batch()                               │
│      ├─ if use_remove_padding:                           │
│      │    ├─ unpad_input(): 移除 padding, 得到连续 token   │
│      │    ├─ if use_ulysses_sp:                          │
│      │    │    ├─ ulysses_pad(): 填充到 sp_size 整数倍     │
│      │    │    └─ ulysses_pad_and_slice_inputs():        │
│      │    │        切分序列到各 SP rank                    │
│      │    ├─ 模型前向 (flash_attn_varlen)                 │
│      │    ├─ if use_ulysses_sp:                          │
│      │    │    └─ gather_outpus_and_unpad(): 聚合并去除填充│
│      │    └─ pad_input(): 恢复原始 batch 形状              │
│      └─ else (不使用 remove_padding):                     │
│           └─ 标准前向计算                                  │
└──────────────────────────────────────────────────────────┘
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 3: 合并结果                                         │
│  ├─ concat 所有 micro batch 的 log_probs                  │
│  └─ if use_dynamic_bsz:                                  │
│       使用 get_reverse_idx() 恢复原始顺序                  │
└──────────────────────────────────────────────────────────┘
update_policy 阶段 (PPO 训练)
输入数据 (DataProto, batch_size = N)
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 1: 划分 Mini Batches                                │
│  num_mini_batches = N / ppo_mini_batch_size              │
│  dataloader = data.chunk(num_mini_batches)               │
└──────────────────────────────────────────────────────────┘
       │
       ▼
  for epoch in ppo_epochs:
    for mini_batch in dataloader:
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 2: 划分 Micro Batches (梯度累积)                     │
│  ├─ if use_dynamic_bsz:                                  │
│  │    使用 rearrange_micro_batches() 按 token 总数动态划分  │
│  │    max_token_len = ppo_max_token_len_per_gpu * sp_size │
│  └─ else:                                                │
│       gradient_accumulation = ppo_mini_batch_size /      │
│                               ppo_micro_batch_size_per_gpu│
│       micro_batches = mini_batch.split(                  │
│                         ppo_micro_batch_size_per_gpu)    │
└──────────────────────────────────────────────────────────┘
       │
       ▼
┌──────────────────────────────────────────────────────────┐
│  Step 3: 梯度累积                                         │
│  optimizer.zero_grad()                                   │
│  for micro_batch in micro_batches:                       │
│      ├─ _forward_micro_batch() (同上, 含 SP 和 rmpad)     │
│      ├─ 计算 policy_loss                                 │
│      ├─ if use_dynamic_bsz:                              │
│      │    loss = policy_loss * (len(data) /              │
│      │                          ppo_mini_batch_size)     │
│      └─ else:                                            │
│           loss = policy_loss / gradient_accumulation     │
│      loss.backward()                                     │
│  optimizer.step()                                        │
└──────────────────────────────────────────────────────────┘
关键关系图
                    ┌─────────────────────────────────────┐
                    │         Total Batch (N samples)      │
                    └─────────────────────────────────────┘
                                      │
                    ┌─────────────────┴─────────────────┐
                    │     ppo_mini_batch_size 划分       │
                    │   (PPO 每次更新使用的样本数)         │
                    └─────────────────┬─────────────────┘
                                      │
              ┌───────────────────────┼───────────────────────┐
              │                       │                       │
        Mini Batch 1            Mini Batch 2            Mini Batch K
              │                       │                       │
              └───────────────────────┼───────────────────────┘
                                      │
                    ┌─────────────────┴─────────────────┐
                    │  use_dynamic_bsz ?                 │
                    └─────────────────┬─────────────────┘
                           ┌──────────┴──────────┐
                           │                     │
                      Yes (动态)             No (固定)
                           │                     │
              ┌────────────┴────────────┐   ┌────┴────┐
              │ rearrange_micro_batches │   │  split  │
              │ 按 max_token_len 划分    │   │ 按固定  │
              │ (平衡各 batch token 数)  │   │ micro   │
              │                         │   │ batch   │
              │ max_token_len =         │   │ size    │
              │ ppo_max_token_len_per_gpu│   │         │
              │ * ulysses_sp_size       │   │         │
              └────────────┬────────────┘   └────┬────┘
                           │                     │
                           └──────────┬──────────┘
                                      │
                              Micro Batches
                                      │
                    ┌─────────────────┴─────────────────┐
                    │  use_remove_padding ?              │
                    └─────────────────┬─────────────────┘
                           ┌──────────┴──────────┐
                           │                     │
                      Yes (移除)             No (保留)
                           │                     │
              ┌────────────┴────────────┐        │
              │ unpad_input()           │        │
              │ 移除 padding, 拼接有效   │        │
              │ token 成连续序列         │        │
              └────────────┬────────────┘        │
                           │                     │
                    ┌──────┴──────┐              │
                    │ ulysses_sp? │              │
                    └──────┬──────┘              │
                    ┌──────┴──────┐              │
                    │             │              │
                Yes (SP)      No (单卡)          │
                    │             │              │
           ┌────────┴────────┐    │              │
           │ ulysses_pad +   │    │              │
           │ slice_inputs    │    │              │
           │ 切分序列到各 rank│    │              │
           └────────┬────────┘    │              │
                    │             │              │
                    └──────┬──────┘              │
                           │                     │
                           └──────────┬──────────┘
                                      │
                              Model Forward
                                      │
                    ┌─────────────────┴─────────────────┐
                    │  后处理: gather + unpad + revert   │
                    └────────────────────────────────────┘
静态 vs 动态 micro-batch 切分对比
假设这张 GPU 拿到 8 条样本, token 长度依次为
[800, 6500, 1200, 4000, 9000, 2500, 1500, 7500], 共 33,000
token。

观察: - 静态切分 (按条数 2): 4 个桶, token 数 [7300, 5200, 11500, 9000], 极差 2.21×, 其中 mb3 已经接近 budget 13312。预算线再低一点就会触发 OOM。 - 动态切分 (按 token 预算 13312): 3 个桶, token 数 [11300, 11200, 10500], 极差 1.08×, 每桶都接近 budget, 没有浪费也没有 OOM 风险。
DP 维度同步: 从「各算各的」到「整齐划一」
动态模式下, 4 张卡各自算出来的 num_micro_batches
大概率不一样。verl 用 all_reduce(MAX) 把它们拉齐, 否则 FSDP
集合通信对不上号会直接 hang。

关键事实澄清:「拉齐」靠的不是补 dummy
padding, 而是让短的 rank 把自己手里的样本切成更多、更稀疏的桶 —
代码里的硬约束是 assert num_micro_batches <= num_groups,
每个桶至少 1 条真实样本, 没有空 batch。短 rank 后续 forward
循环里跑的是稀疏的真样本而非 padding。
遗留隐患: verl 在进 dynamic_bsz
之前其实还有一层全局 KK 平衡 (_balance_batch, 由
trainer.balance_batch=True 默认开),
会先重排样本让各 rank 总 token 数尽量接近 (log 里
global_seqlen/balanced_min/max 就是它的产物)。但它有
equal_size=True 的硬约束 (每 rank 等条数),
且只平衡总和不平衡每个 micro-batch
的工作量。所以单条特别长的样本仍可能让某 rank 的某个 micro-batch 慢得多,
触发 NCCL watchdog timeout (issue #5750
的根因之一)。
关键代码逻辑
动态批处理
(use_dynamic_bsz)
# 核心函数: rearrange_micro_batches()
# 使用 Karmarkar-Karp 算法平衡各 micro batch 的 token 总数
max_token_len = ppo_max_token_len_per_gpu * ulysses_sequence_parallel_size
micro_batches, indices = rearrange_micro_batches(batch, max_token_len)

# Loss 缩放 (保证梯度正确)
loss = policy_loss * (len(data) / ppo_mini_batch_size)
移除 Padding
(use_remove_padding)
# 移除 padding
input_ids_rmpad, indices, cu_seqlens, *_ = unpad_input(input_ids.unsqueeze(-1), attention_mask)

# 模型使用 flash_attn_varlen 进行计算
output = self.actor_module(input_ids=input_ids_rmpad, attention_mask=None, ...)

# 恢复原始形状
full_log_probs = pad_input(hidden_states=log_probs.unsqueeze(-1), indices=indices, batch=batch_size, seqlen=seqlen)
序列并行
(ulysses_sequence_parallel_size > 1)
# 填充并切分输入
input_ids_rmpad, position_ids_rmpad, pad_size = ulysses_pad_and_slice_inputs(
    input_ids_rmpad, position_ids_rmpad, sp_size=self.ulysses_sequence_parallel_size
)

# 模型前向后聚合结果
log_probs = gather_outpus_and_unpad(log_probs, gather_dim=0, unpad_dim=0, padding_size=pad_size)
梯度累积关系
# 固定 batch size 模式
gradient_accumulation = ppo_mini_batch_size // ppo_micro_batch_size_per_gpu
loss = policy_loss / gradient_accumulation

# 动态 batch size 模式
loss = policy_loss * (len(data) / ppo_mini_batch_size)  # 按实际样本数比例缩放
参数配合使用的典型场景
| 场景 | use_dynamic_bsz | use_remove_padding | ulysses_sp | 说明 |
|---|---|---|---|---|
| 基础训练 | ❌ | ❌ | ❌ | 固定 batch size, 标准 attention |
| 长序列优化 | ❌ | ✅ | ❌ | 移除 padding 减少无效计算 |
| 负载均衡 | ✅ | ❌ | ❌ | 动态划分 batch 平衡各 GPU 计算量 |
| 长序列 + 负载均衡 | ✅ | ✅ | ❌ | 推荐配置, 效率最高 |
| 超长序列 | ✅ | ✅ | ✅ | 序列并行支持超长序列训练 |
参数生效速查表
遇到”我设了这个参数怎么没用”的时候回来看一眼。
| 参数 | use_dynamic_bsz=False |
use_dynamic_bsz=True |
说明 |
|---|---|---|---|
*.ppo_micro_batch_size_per_gpu |
生效 | 忽略 | 每卡 micro-batch 的样本条数 |
*.log_prob_micro_batch_size_per_gpu |
生效 | 忽略 | compute_log_prob / ref_log_prob 用 |
actor.ppo_max_token_len_per_gpu |
忽略 | 生效 | actor 训练 micro-batch 的 token 上限 |
ref / rollout.log_prob_max_token_len_per_gpu |
忽略 | 生效 | 前向算 logprob 时的 token 上限 |
critic.ppo_max_token_len_per_gpu |
忽略 | 生效 | critic 用 dynamic 时才生效 |
data.max_prompt_length / max_response_length |
生效 | 生效 | 跟 dynamic_bsz 无关, 是单条样本的硬上限 |
rollout.max_model_len / max_num_batched_tokens |
生效 | 生效 | vLLM 引擎参数, 跟训练侧切分无关 |
总结
batch size 概念分层: 全局
train_batch_size→ 每个 DP rank 上的ppo_mini_batch_size(per-GPU shard) → 每个 rank 内的 micro-batch。RL 训练里不同位置说”batch_size”往往指不同含义, 跟 TP/SP/DP 维度乘在一起。两条切分路径:
use_dynamic_bsz=False走静态 (按条数等分);use_dynamic_bsz=True走动态 (按 token 预算 + KK 算法)。后者能避免长样本 OOM 和短样本 padding 浪费, 但代价是实现复杂。两层 KK 平衡:
_balance_batch负责 rank 之间的总 token 平衡 (equal_size=True); dynamic_bsz 负责每个 rank 内 micro-batch 的 token 平衡 (equal_size=False)。两层叠加才能让各 rank 的每个 micro-batch 都接近 workload。DP 同步关键: dynamic_bsz 必须配
all_reduce(MAX)把num_micro_batches拉齐, 否则 FSDP 的all_gather循环次数不一致, 直接 NCCL hang。这是 dynamic 模式最容易踩的坑, 对应多个 issue #5750、#3873、#12 等 hang 问题。推荐配置:
use_dynamic_bsz=True+use_remove_padding=True, 处理变长序列时效率最高。如果需要支持超长序列 (单条超过单卡能容纳的长度), 再叠ulysses_sequence_parallel_size > 1。Loss 缩放差异:
- 固定 batch size:
loss = policy_loss / gradient_accumulation - 动态 batch size:
loss = policy_loss * (len(data) / ppo_mini_batch_size)— 按实际样本数比例缩放, 等价于”按权重”对每个 micro-batch 的梯度归一化。
- 固定 batch size:
参考
- 浅入理解verl中的batch_size
- batch size 是怎么被切开的 (syt-nju) — 本文”两条切分路径”、“_balance_batch”、“DP 同步”、“参数生效速查表”四节主要整理自这篇博客
- Performance Tuning Guide — verl docs
- issue #5750 — NCCL timeout during compute_log_prob
- issue #3873 — DAPO+Megatron+SGLang hang
- PR #5110 — upcast seq_len_effective to int64
- issue #6073 — VLM nested tensor jagged 翻转
- issue #12 — Hangs during vllm rollout
- [[DataProto]] — 数据分发与 dispatch mode
- [[device_mesh]] — DP/TP/SP 维度